[Prometheus] Thanos & Sharding 본문
Prometheus는 메트릭 수집 기능 및 시각화, 쿼리 기능을 제공하며 모니터링에서 사실상 표준 처럼 사용되고 있다.
하지만, 프로메테우스는 단일 노드 시스템으로 설계되어 있기에 확장성과 고가용성 측면에서 부족함이 존재한다. 거기에 수집한 시계열 데이터를 로컬 디스크에 저장하기에 데이터의 영구 보존이 어렵다는 단점을 안고 있다.
이런 단점을 보완하기 위해 등장한 것이 바로 Thanos 다.
Thanos는 위에서 언급됐던 Prometheus의 단점을 모두 보완할 수 있다.
Prometheus 서버에 Thanos Sidecar가 함께 배포된다. Prometheus는 수집된 데이터를 기본적으로 2시간 간격으로 TSDB Block으로 압축하여 로컬 디스크에 저장하는데, Thanos Sidecar는 TSDB Block이 완성되면 이를 감지하여 원격 저장소에 자동으로 업로드한다.
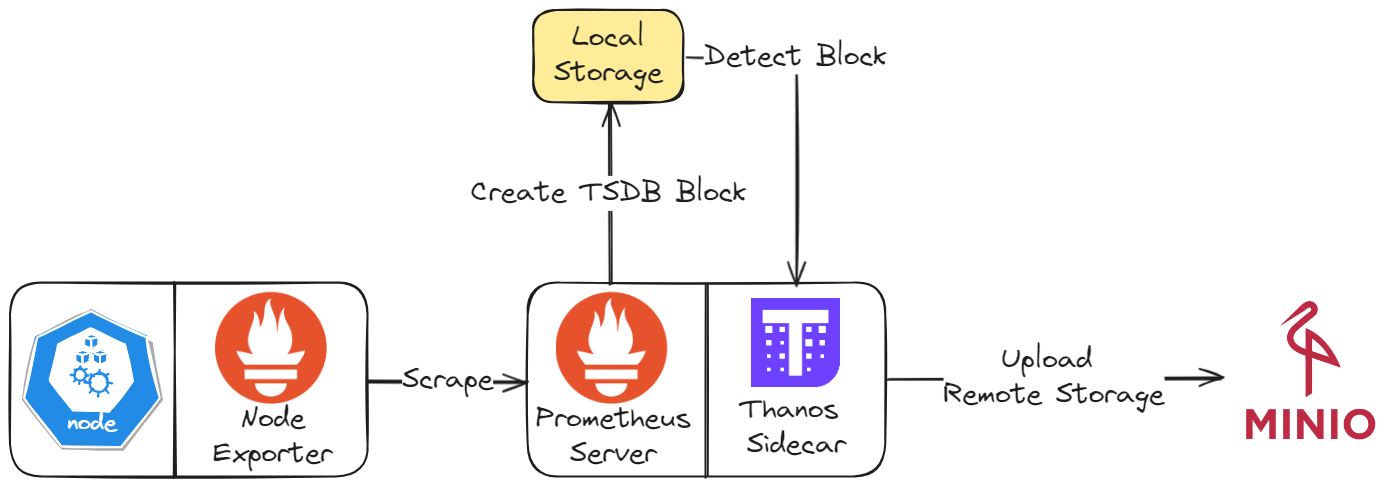
추가적으로 Prometheus는 쌓여있는 작은 TSDB Block을 로컬에서 Compaction(압축)을 통해 하나의 큰 블록 단위로 만드는 작업을 진행한다. 하지만 Thanos를 함께 사용하는 경우 병합된 새 블록의 ID와 구조가 이전의 것과 달라지기 때문에 중복 업로드나 데이터 불일치가 발생할 수 있다.
따라서 Prometheus의 Compaction 기능을 비활성화 하고 Thanos Compactor를 사용하는 것이 좋다. Thanos Compactor를 사용하게 되면, 로컬이 아닌 원격 저장소 내에서 Compaction을 시행하게 된다.
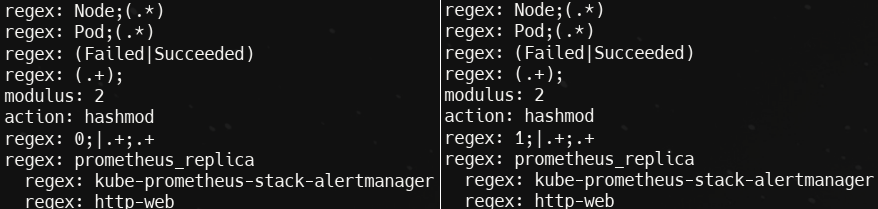
Prometheus는 Sharding을 통해 데이터를 분산 저장할 수 있다. 메트릭 주소값(__address__)을 md5로 해싱하여 'tmp_hash' 라벨로 매핑한 뒤 'modules' 값으로 나눈 나머지 값에 따라 각 프로메테우스 인스턴스에 대해 타겟으로 설정된다. 만약 나눈 나머지의 값이 0이라면 'regex'가 0인 prometheus-0으로 1일 경우 prometheus-shard-1-0으로 메트릭이 스크랩된다.
데이터의 영구 저장 이외에도 Prometheus는 인스턴스를 늘리는 경우, 동일 대상으로 중복된 데이터를 수집하게 되는데 이러한 문제도 Thanos를 통해 해결이 가능하다.
Thanos Query는 replicaLabel을 통해 조회 시점에 중복된 데이터를 하나로 통일하여 반환한다.
예를 들어 Prometheus에서 수집한 데이터의 라벨이
- Prometheus + sidecar “A”: cluster=1,env=2,replica=A
- Prometheus + sidecar “B”: cluster=1,env=2,replica=B
위의 예제와 같을 때, replica를 제외한 라벨의 값이 모두 동일하기 때문에 Thanos Query는 이를 다른 프로메테우스에서 수집된 동일한 데이터로 판단하고 쿼리 결과에서 하나의 값만을 반환한다.
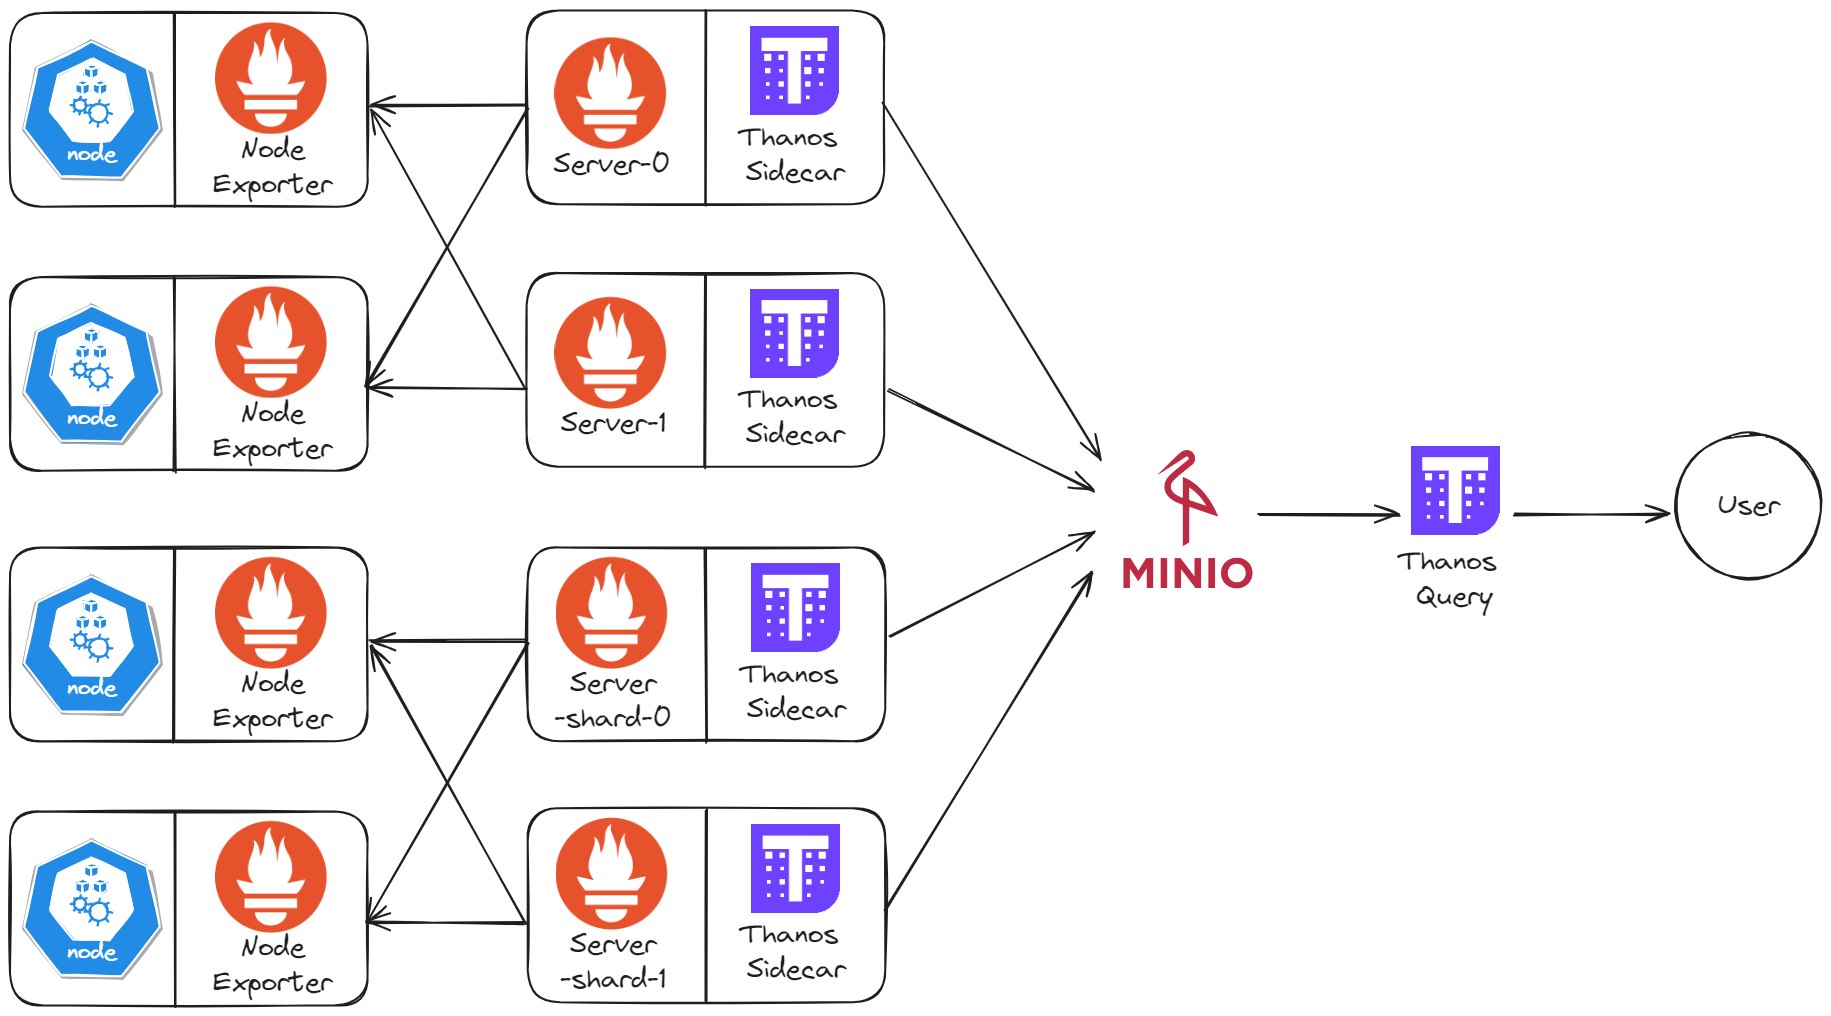
만약 Sharding을 진행했다면, 분리된 데이터를 Thanos Query가 하나로 통합하여 보내주기 때문에 Grafana와 같은 대시보드 사용 시 매우 유용하다.
'DevOps' 카테고리의 다른 글
| [Prometheus] Re-Labeling (0) | 2026.03.03 |
|---|---|
| [Prometheus] Recording Rules (0) | 2026.02.27 |
| [Prometheus] Histogram & Summary (0) | 2026.02.26 |
| [o11y] Intro-to-mltp - LogQL (0) | 2025.03.18 |
| [o11y] Intro-to-mltp (0) | 2025.03.11 |


